콘솔
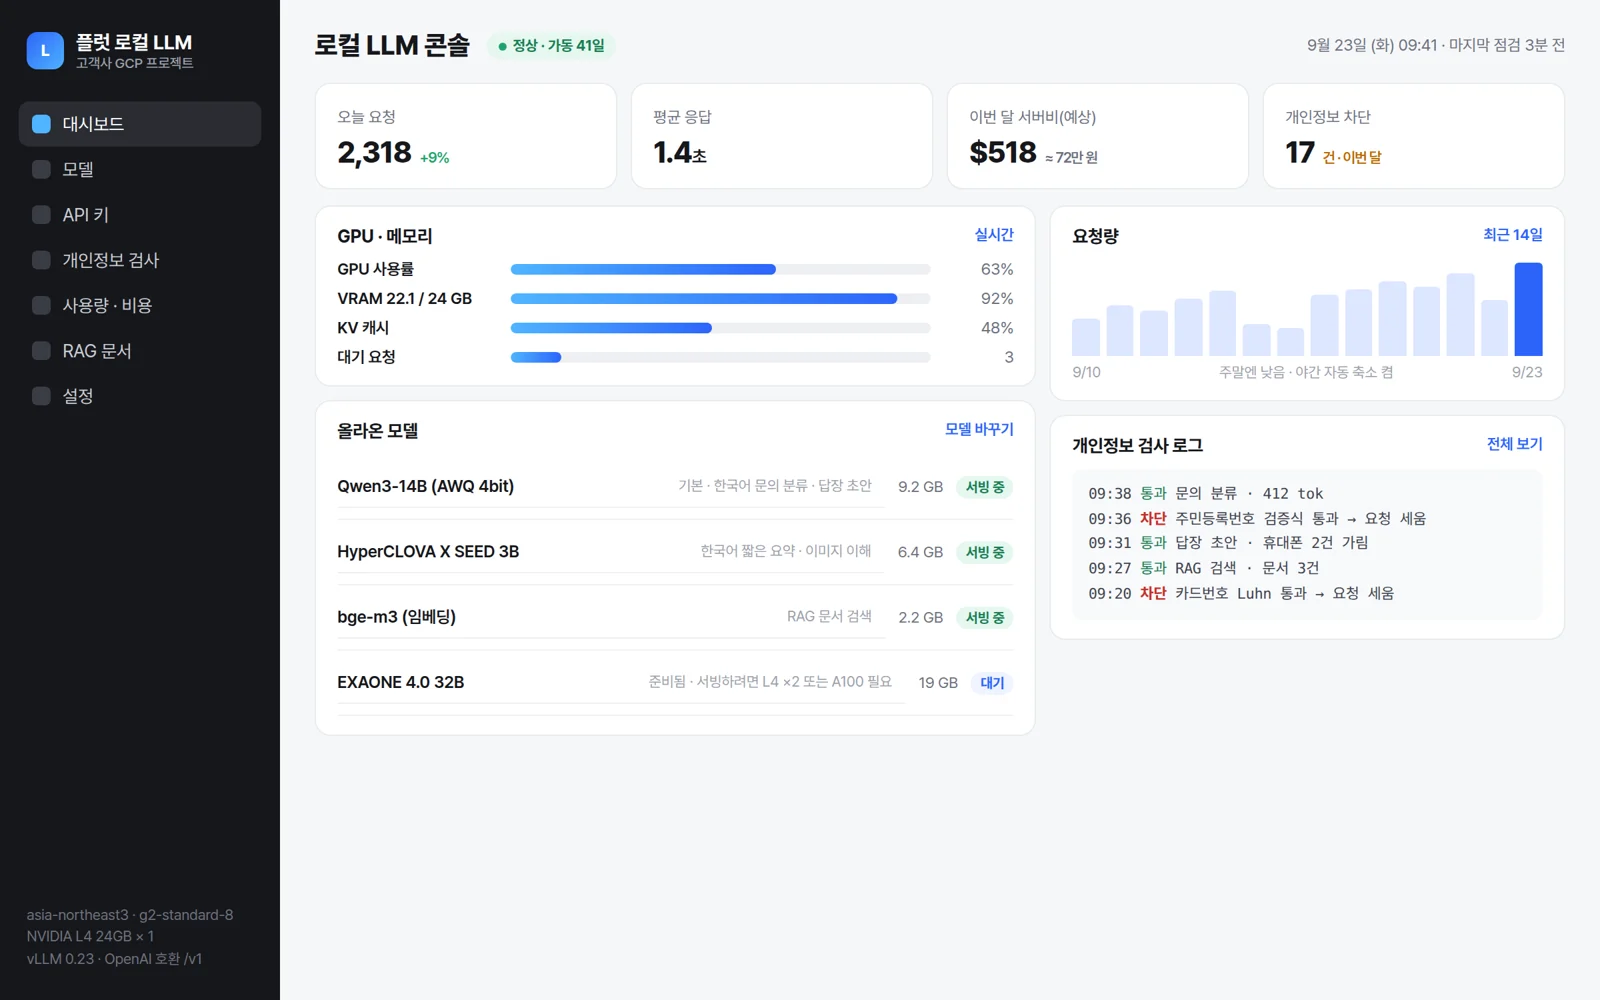
GPU · 요청량 · 비용 · 차단 로그를 한 화면에
어떤 모델이 얼마나 메모리를 쓰는지, 오늘 몇 건이 들어왔는지, 이번 달 서버비가 얼마로 가는지, 개인정보 검사가 무엇을 막았는지. 운영 계약이 없어도 이 화면은 남습니다.
제품
GCP · AWS · 사내 서버 어디든. 데이터가 밖으로 나가지 않고, 월 사용료 대신 서버비만 냅니다. 오픈 웨이트 모델을 vLLM으로 서빙하고 OpenAI 호환 API로 내어 드리니, 쓰시던 코드는 한 줄도 안 바꿉니다.
셋 중 하나면 맞고, 아니면 API 게이트웨이가 더 쌉니다
의료 · 법무 · 인사 · 금융 자료, 계약상 국외 이전 금지. 모델이 고객 계정 안에서만 돌고, 우리도 데이터를 보지 않습니다.
하루 수천 건 이상이면 서울 리전 L4 한 장(온디맨드 월 약 93~101만 원, 약정 시 절반)이 API 요금보다 쌉니다. 진단 때 실제 사용량으로 손익분기를 계산해 드립니다.
용어 · 서식 · 말투를 LoRA 로 학습. 학습 데이터는 고객 서버를 떠나지 않고, 결과에는 사람 확인 단계를 둡니다.
반대로 하루 수백 건 이하 · 최신 최상위 모델이 꼭 필요 · 운영 인력 없음 이면 AI API 게이트웨이가 맞습니다. 진단에서 그렇게 말씀드립니다(진단은 무료).
부가세 별도 · 서버비는 고객 계정으로 직접 결제
표준 2주
Qwen3-14B 또는 Kanana 8B + 임베딩. 동시 5~10명, 문의 분류 · 답장 초안 · 요약
표준 3주
Qwen3-32B · EXAONE 4.0 32B · Kanana 32B. 동시 20~50명, 사내 문서 RAG
표준 4주~
70B · MoE 모델, LoRA 파인튜닝, 동시 100명+
운영 계약 없이 구축만 받으셔도 됩니다. 인수인계 문서와 3개월 무상 장애 대응이 구축에 포함됩니다. 사내 서버 설치는 같은 단가에 출장비 실비.
2026년 9월 23일 공식 요금표 · 온디맨드 · 서울 리전 기준(미국 리전은 비교용)
| 클라우드 | 인스턴스 | GPU | 미국 시간당 | 서울 시간당 | 서울 월(730h) | 원화(1,400원/$) |
|---|---|---|---|---|---|---|
| AWS | g6.xlarge | NVIDIA L4 24GB × 1 | $0.80 | $0.99 | $722 | 101만 원 |
| AWS | g5.2xlarge | NVIDIA A10G 24GB × 1 | $1.21 | $1.49 | $1,088 | 152만 원 |
| AWS | g6.12xlarge | NVIDIA L4 24GB × 4 | $4.60 | $5.66 | $4,130 | 578만 원 |
| AWS | p5.48xlarge ÷ 8 | NVIDIA H100 80GB × 1 (8장 인스턴스의 1장분) | $6.88 | $9.49 | $6,931 | 970만 원 |
| GCP | g2-standard-4 | NVIDIA L4 24GB × 1 | $0.71 | $0.91 | $663 | 93만 원 |
| GCP | a2-highgpu-1g | NVIDIA A100 40GB × 1 | $3.67 | $4.05 | $2,956 | 414만 원 |
서울 리전은 미국보다 10~38% 높습니다(실측: AWS L4 +23%, A10G +23%, H100 +38%, GCP L4 +28%, A100 +10%). 1년 약정이나 스팟(중단 허용)은 40~70% 낮아지고(예: 서울 g6.xlarge 스팟 약 $0.57, g5.2xlarge 스팟 약 $0.69), 야간 · 주말 자동 축소를 켜면 소형 구성은 월 40만 원대까지 내려갑니다. 사내 서버는 24GB GPU 워크스테이션 구매(대략 수백만 원, 견적 별도) 뒤 전기 · 회선만 듭니다. 정확한 월비는 진단 때 실제 사용량으로 계산해 드립니다.
데이터가 국내에 있어야 하면 서울, 서울에 GPU 가 없으면 도쿄, 국외 이전이 허용되면 미국이 가장 쌉니다. 2026년 9월 23일 각 클라우드 공식 문서 확인.
| 클라우드 | 리전 | 쓸 수 있는 GPU | 비고 |
|---|---|---|---|
| AWS | 서울 ap-northeast-2 | L4(G6) · A10G(G5) · A100(P4d) · H100(P5 · P5e) | 전부 가능. 소형~대형 모두 서울에서 |
| AWS | 도쿄 ap-northeast-1 | L4(G6) · A10G(G5) · H100(P5 단일 GPU는 Capacity Blocks) | 서울 매진 시 대안. 지연 30ms 안팎 |
| AWS | 미국 버지니아 · 오하이오 · 오리건 | 전 GPU · 가장 쌈(서울 대비 −20~30%) | 데이터 국외 이전이 허용될 때만 |
| GCP | 서울 asia-northeast3 | L4(G2, a·b 존) · A100 40GB(A2, b 존) · H100(A3 High · A3 Edge, c 존) | 전부 가능. A100 은 b 존 하나라 예약 권장 |
| GCP | 도쿄 asia-northeast1 | L4(G2, a·b·c) · A100 40GB(A2, a·c) · H100(A3 Mega, b) · B200(A4, b) | 서울보다 GPU 종류가 많음. 요금은 서울과 같음 |
| GCP | 미국 us-central1 등 | 전 GPU · 가장 쌈 | 데이터 국외 이전이 허용될 때만 |
| 사내 | 고객 서버실 · IDC | NVIDIA 24GB 이상(RTX 4090 · 5090 · A6000 · L40S 등) 리눅스 | 같은 절차로 설치. 사양 · 견적 같이 잡음 |
전부 오픈 웨이트 · 라이선스와 필요한 GPU 메모리를 같이 적었습니다
| 구분 | 모델 | 크기 | 만든 곳 · 라이선스 | 특징 | GPU 메모리(대략) |
|---|---|---|---|---|---|
| 한국어 | EXAONE 4.0 | 32B · 1.2B | LG AI연구원 | 추론 모드 · 도구 사용. 상업 이용은 LG와 별도 계약 필요 | 32B: 4bit 약 20GB(L4 1장) · FP16 64GB(A100 ×2) |
| 한국어 | HyperCLOVA X SEED | 0.5B · 1.5B · 3B | 네이버 | 3B는 이미지 이해. 상업 이용 허용(일부 조건 제외) | 3B: 8GB 안팎, L4 1장에 다른 모델과 병행 |
| 한국어 | Kanana 1.5 | 8B · 32B | 카카오 | 한국어 특화, 라이선스 자유도 높음(Apache 2.0 에 가까움) | 8B: 4bit 5GB · 32B: 4bit 20GB |
| 한국어 | A.X 4.0 | 7B · 72B | SK텔레콤 | 공개 모델. 72B는 H100급 | 7B: 4bit 5GB · 72B: 4bit 40GB+ |
| 범용 | Qwen3 | 8B · 14B · 32B · 235B-A22B | Alibaba (Apache 2.0) | 한국어 성능 좋음 · 도구 사용 · 긴 문맥. 기본 추천 | 14B: 4bit 9GB · 32B: 4bit 18~20GB · 235B: 130GB+ |
| 범용 | Gemma 3 | 4B · 12B · 27B | Google (Gemma 라이선스) | 이미지 입력 · 128K 문맥 | 12B: 4bit 8GB · 27B: 4bit 16~18GB |
| 범용 | Llama 4 Scout · Llama 3.x | 8B · 70B · Scout(109B MoE) | Meta (Llama Community License) | MAU 7억 이상 별도 계약. 영어 강함 | 70B: 4bit 40GB · Scout: 4bit 62GB |
| 범용 | Mistral Small 3 · Phi-4 · DeepSeek-R1 Distill | 7B~32B | Mistral · Microsoft · DeepSeek (Apache 2.0 · MIT) | 가벼운 추론 · 코드 | 4bit 5~20GB |
| 임베딩 | bge-m3 · multilingual-e5 | 0.3B~0.6B | BAAI · Microsoft (MIT) | RAG 문서 검색용. 한국어 지원 | 1~3GB, LLM과 같은 GPU에 병행 |
4bit = AWQ · GPTQ 양자화. 품질을 조금 내주고 메모리를 3~4분의 1로 줄입니다. 라이선스는 진단 때 고객사 용도(상업 · 사용자 수)에 맞춰 확인해 드리고, 특히 EXAONE 은 상업 이용 계약이 따로 필요합니다. 목록에 없는 모델도 vLLM 이 지원하면 올릴 수 있습니다.
구축이 끝나면 이 상태입니다
콘솔
어떤 모델이 얼마나 메모리를 쓰는지, 오늘 몇 건이 들어왔는지, 이번 달 서버비가 얼마로 가는지, 개인정보 검사가 무엇을 막았는지. 운영 계약이 없어도 이 화면은 남습니다.
무료 진단에서 잰 사용량으로 GPU 크기와 모델을 고릅니다. 고객 GCP 프로젝트 · AWS 계정에 우리가 권한을 받아 만들고, 끝나면 권한을 돌려드립니다. 사내 서버면 OS · 드라이버부터.
vLLM 으로 모델을 올리고 OpenAI 호환 /v1 을 내어 드립니다. base_url 만 바꾸면 기존 코드가 그대로 돕니다. 보내기 전 개인정보 검사(주민등록번호 · 카드번호는 검증식 통과분만 세움, 휴대폰 · 이메일은 가림)를 기본으로 켭니다.
사내 문서를 임베딩해 검색-생성(RAG)을 붙이고, 모델 2~3종을 무중단으로 바꿀 수 있게 합니다. 동시 사용자 수를 실제로 걸어 응답 시간을 재고 보고서로 드립니다.
설치 문서 · 되돌리기 절차 · 비용 절감 설정(약정 · 스팟 · 자동 축소)을 정리해 드리고, 3개월간 장애 대응은 무상입니다. 이후는 운영 계약 또는 건별.
아니요. 오픈 웨이트 32B 급은 최상위 상용 모델보다 어렵고 긴 과제에서 뒤집니다. 문의 분류 · 답장 초안 · 요약 · 사내 문서 검색처럼 «정해진 일»은 충분하고, 그게 로컬 LLM 의 자리입니다. 진단에서 고객 실제 문서로 미리 돌려 보고 결정합니다.
구축 기간에도 모델 · 로그는 고객 계정 안에 있습니다. 우리는 권한을 받아 설치하고 끝나면 반납합니다. 학습에 쓰지 않고, 콘솔의 검사 로그도 원문이 아니라 «무엇을 막았는지»만 남깁니다.
원칙적으로 고객 계정 직접 결제입니다. 계정이 고객 것이어야 데이터 · 비용 · 되돌리기가 전부 고객 손에 남습니다. 계정 만들기부터 같이 해 드립니다.
네. 둘 다 OpenAI 호환 규격이라 base_url 만 바꾸면 됩니다. 반대로 게이트웨이를 쓰다 사용량이 늘면 로컬로 옮기는 것도 같은 방식입니다.
됩니다. 24GB 이상 NVIDIA GPU 가 있는 리눅스 서버면 같은 절차로 설치합니다. 없으면 워크스테이션 사양과 견적을 같이 잡아 드립니다.
로컬 LLM 이 맞는지부터
무료 진단으로 확인하세요
 우리 회사 AX를
안녕하세요, 위트봇이에요.
팀플럿 AX사업부에서 AI 도입 상담을 맡고 있어요.
궁금한 걸 그냥 편하게 물어보세요. 사람이 봐야 하는 건 상담원에게 바로 이어 드려요.
답변은 AI가 만들어요 · 대화를 시작하면 개인정보 처리방침에 동의한 것으로 봐요